顶级大模型在 HumanEval-V 上不到 37%:视觉推理才是短板,不是写代码
在一个 253 个任务的新基准上,模型必须把示意图变成可运行的代码。Claude 3.5 Sonnet 只到 36.8% pass@1,Pixtral 124B 到 21.3%,而很多开源权重模型低于 10%。
HumanEval-V 是一个包含 253 个人工标注任务的基准,要求大语言多模态模型直接从示意图读出算法逻辑,输出可运行的 Python。在 27 个最先进的多模态模型上,最好成绩也只有 36.8% pass@1。作者证明真正的失分点是高层视觉推理,而不是编码能力。
为什么重要
虽然大语言多模态模型(LMM)近年来在多个领域展现出强大的视觉能力,但它们在编码场景下的视觉推理能力仍基本未被探索。
关键发现
- 数据集与工作量 253 个人工标注的代码生成任务,覆盖 6 个视觉类别,来自超过 800 小时的标注(4 位标注员 × 200 小时);100 个种子问题被重新创建并扩充到 253 个任务。
- 核心结果 顶尖多模态模型在这个任务上很弱:Claude 3.5 Sonnet 和 Pixtral 124B 只有 36.8% 和 21.3% pass@1,而许多开源权重模型低于 10%。
- 视觉到代码是瓶颈 当视觉理解与代码生成解耦时(V2T2C 搭配 GPT-4o:Claude 3.5 Sonnet 43.7% pass@3,而直接 V2C 只有 28.1% pass@1),模型表现最好,说明视觉到代码的对齐是主要短板。
- 编码能力不是问题 给定人工编写的题目说明,GPT-4o 跃升到 96.5% pass@3(对比 V2T2C 的 40.5%);只给函数签名(没有示意图或描述)时,五个闭源模型得 0%。
- 与现有基准的弱关联 在通用基准上领先的模型在 HumanEval-V 上大幅失灵,例如 Claude 3.5 Sonnet 在 AI2D 得 81.2、MMBench 得 81.7、MathVista 得 67.7,但在 HumanEval-V 上只有 43.7%,暴露出多模态评测的盲区。
HumanEval-V
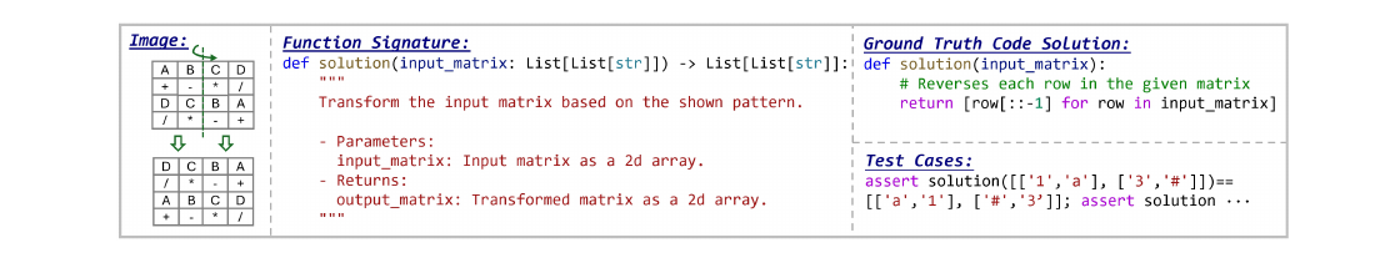
- 任务形式:每个任务把一个自包含的示意图(编码算法逻辑)与一个 Python 函数签名(输入 / 返回类型)和一组测试用例配对,设计上尽量少的文字描述。
- 构建方式:四步人工流水线:收集与筛选题目(Codeforces、LeetCode、GeeksforGeeks、Stack Overflow),提炼视觉本质,重建 100 个种子任务,再用 GPT-4o 扩充到 253 个任务。
- 分类体系:六种视觉任务类型(迭代、聚合、扩展、校验、计算、重排)和六个能力维度。
- 评测框架:四条流水线:V2C、带 CoT 的 V2C、V2T2C、以及 V2T2C 搭配 GPT-4o(解耦:一个强大的编码模型根据模型自己写的示意图描述生成代码),以 pass@1 / pass@3 报告并折算到 pass@100。
对实践者的意义
为视觉编程任务挑选多模态模型时,别太相信通用多模态基准:HumanEval-V 的得分和它们之间关系很差。即便最先进的模型,也会在编码空间变换、拓扑关系和动态模式的示意图上失败;幻觉出的视觉细节很常见。两阶段流水线(让模型先描述示意图,再用一个强大的编码模型生成代码)能显著提升表现,基于执行结果的反馈用于迭代自我纠错同样有效。
获取论文与引用
官方引用:Fengji Zhang, Linquan Wu, Huiyu Bai, Guancheng Lin, Xiao Li, Xiao Yu, Yue Wang, Bei Chen, Jacky W. Keung(2026)。HumanEval-V: Systematic Evaluation of Visual Reasoning in Large Multimodal Models for Code Generation.ACM Transactions on Software Engineering and Methodology. DOI: 10.1145/3813804.